
Guía práctica para empresas · Propuesta editorial: martes 3 de noviembre de 2026 · Bárbara Regina Ribeiro · BRR
Una empresa puede contratar un modelo de inteligencia artificial con un precio aparentemente muy competitivo y terminar descubriendo que el proyecto cuesta mucho más de lo previsto. También puede suceder lo contrario: una solución cuyo precio por millón de tokens parece elevado puede resultar más económica porque necesita menos reintentos y menos correcciones humanas. El precio del modelo no es el coste del proceso.
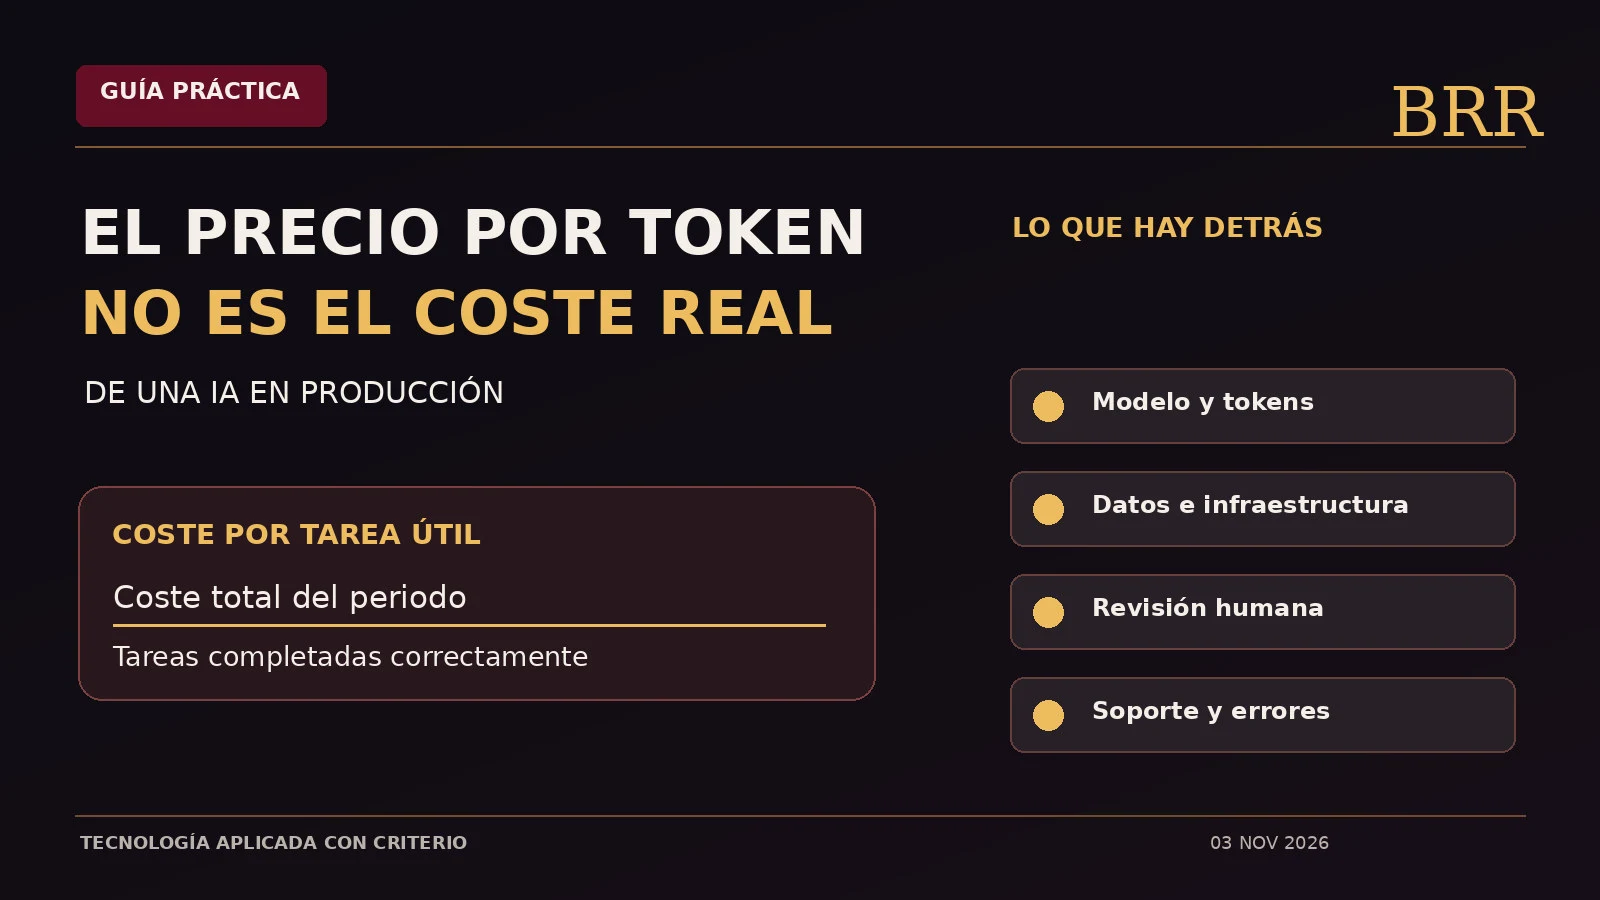
Cuando una organización quiere llevar un asistente, un agente o una automatización a producción, mi propuesta es empezar por una pregunta distinta de «¿cuánto cuesta cada consulta?»: ¿cuánto nos cuesta completar correctamente una tarea de negocio, de principio a fin, con el nivel de calidad que necesitamos?
Esa unidad de análisis ayuda a comparar opciones sin confundir consumo técnico con valor empresarial. No sustituye el análisis de seguridad, cumplimiento o viabilidad. Lo complementa con una forma más clara de decidir.
Primero hay que definir qué cuenta como tarea completada
Imaginemos un caso hipotético: una empresa recibe solicitudes de clientes y quiere que una herramienta de IA clasifique cada petición, consulte documentación autorizada y prepare una respuesta para revisión. La organización podría medir el número de llamadas al modelo, los tokens procesados o el tiempo de generación. Pero ninguno de esos indicadores demuestra por sí mismo que el cliente haya recibido una respuesta útil.
Para el piloto, convendría definir una unidad de negocio: «solicitud resuelta correctamente y validada, sin una corrección posterior relevante». Esa definición debe acordarse con quienes conocen el proceso. Si una consulta se envía a una persona porque el sistema no tiene información suficiente, también necesitamos decidir si se contabiliza como derivación correcta o como tarea no completada por la IA. Ambas mediciones pueden ser útiles, siempre que no se mezclen.
La FinOps Foundation promueve relacionar el gasto tecnológico con el valor que generan los equipos y las unidades de negocio. El pilar de optimización de costes de AWS Well-Architected también insiste en comprender el consumo, seleccionar recursos adecuados y optimizar continuamente. Aplicado a la IA, eso significa dejar de tratar cada token como si fuera un resultado.
El coste completo tiene más componentes que la factura de la API
La primera partida suele ser visible: tokens de entrada, tokens de salida, consultas, minutos de audio o capacidad de cómputo. Los proveedores publican precios diferentes según modelo, modalidad, procesamiento y condiciones. Por eso conviene consultar la tabla oficial de precios de OpenAI o la del proveedor correspondiente el mismo día que se realiza una estimación. No fijaría una tarifa genérica en un artículo que puede consultarse dentro de varios meses.
Pero el coste total de una operación puede incluir además almacenamiento de documentos, indexación y búsqueda, bases de datos, llamadas a herramientas, infraestructura, tráfico de red, monitorización, registros, evaluaciones, soporte y mantenimiento. Si el sistema utiliza un modelo alojado en servidores propios, hay que considerar amortización, energía, administración, capacidad ociosa y sustitución de hardware. Si utiliza una API, aparecen otros elementos como límites de servicio, dependencia de red y condiciones contractuales.
Hay una partida que muchas veces se omite: el tiempo humano. Revisar respuestas, corregir errores, preparar datos, mantener instrucciones, analizar incidencias y responder a clientes forma parte del coste operativo. Una automatización que genera borradores en segundos, pero necesita una revisión de diez minutos por cada caso, puede no mejorar el proceso.
También debemos contabilizar los fallos. Un agente que repite una consulta o encadena herramientas puede multiplicar llamadas y gastos. OWASP recoge explícitamente el riesgo de agotamiento de recursos por encadenamiento de herramientas sin límites. Un presupuesto máximo por ejecución y mecanismos de parada no son solo controles financieros: también forman parte de una operación responsable.
Una fórmula que sí ayuda a comparar alternativas
Propongo utilizar una métrica sencilla, con una condición importante: las tareas correctas deben evaluarse con criterios comparables.
Coste por tarea útil = coste total del periodo / número de tareas completadas correctamente.
El numerador puede incluir costes de inferencia, herramientas, infraestructura, supervisión, mantenimiento y correcciones. El denominador debe excluir tareas incompletas o erróneas, o contabilizarlas en categorías separadas. La fórmula es fácil de explicar a un comité de dirección y permite comparar el piloto con el proceso actual.
Veamos un ejemplo enteramente hipotético. Durante un mes se reciben 1.000 solicitudes. El sistema automatizado procesa las 1.000, pero solo 800 cumplen los criterios de resolución correcta sin rehacer el trabajo. La suma de los costes del mes atribuibles al proceso —servicios técnicos, revisiones, soporte y amortización pertinente— es de 640 euros. El coste por solicitud procesada sería de 0,64 euros. Sin embargo, el coste por tarea completada correctamente sería de 0,80 euros: 640 dividido entre 800.
Ese segundo número es más útil. Aun así, no demuestra que el proyecto sea rentable. Necesitamos compararlo con el coste y la calidad del procedimiento anterior, considerar las 200 solicitudes que no se completaron y comprobar si han aparecido nuevas incidencias. Si esas solicitudes requieren trabajo adicional no incluido en los 640 euros, el cálculo todavía está incompleto.
Podemos añadir una métrica de tiempo: minutos humanos por tarea útil. Y otra de calidad: porcentaje de tareas correctas tras una revisión independiente. Cuando ambas evolucionan favorablemente, empezamos a tener una base razonable para decidir si conviene ampliar el sistema.
Cómo diseñaría un piloto para que los números sirvan
1. Delimitar el proceso. Seleccionaría una tarea suficientemente frecuente y homogénea, con datos disponibles y una persona responsable. No comenzaría con «automatizar toda la atención al cliente». Es demasiado amplio para evaluar qué funciona.
2. Construir una muestra representativa. Incluiría casos fáciles, habituales, ambiguos y excepcionales. La muestra debe reflejar el trabajo real, sin incluir datos personales innecesarios ni vulnerar permisos. Si solo probamos ejemplos sencillos, el resultado será optimista por diseño.
3. Medir la línea de base. Antes de introducir IA, registraría tiempo, errores, costes y calidad del proceso actual. Sin una referencia comparable, cualquier ahorro anunciado será difícil de justificar.
4. Probar dos o tres configuraciones. No necesariamente dos o tres proveedores. A veces basta con comparar un modelo más pequeño, otro más capaz y una variante con recuperación de documentación. Mantendría constantes los casos y los criterios de evaluación.
5. Registrar el recorrido completo. Cada ejecución debería dejar constancia de llamadas, consumo, herramientas, reintentos, errores, tiempo de revisión y resultado final. Los registros deben minimizar datos sensibles y aplicar las reglas de acceso y conservación que correspondan.
6. Incorporar límites operativos. Presupuesto máximo por tarea, tiempo de espera, número de reintentos, permisos mínimos y derivación a una persona cuando el sistema no pueda continuar con seguridad. Un flujo que se detiene correctamente puede ser más valioso que uno que improvisa una respuesta.
7. Evaluar calidad y coste juntos. Un modelo puede costar menos por consulta y fallar más. Otro puede acertar más, pero exigir una infraestructura desproporcionada. El análisis debe mostrar la relación entre calidad, tiempo, riesgo y gasto.
8. Decidir si escalar, rediseñar o detener. El resultado del piloto no tiene que ser siempre un despliegue. A veces la mejor decisión es mejorar los datos, simplificar el proceso o no automatizar una tarea concreta.
Qué medir en el cuadro de mando
Un cuadro de mando inicial no necesita veinte gráficos. Yo comenzaría con cinco indicadores: volumen de tareas recibidas; porcentaje de resolución correcta; coste total y coste por tarea útil; tiempo humano por tarea; e incidencias que requieren corrección o escalado. A partir de ahí se pueden añadir latencia, disponibilidad, satisfacción, consumo por cliente y gasto por equipo cuando sean relevantes.
La medición debe separar entornos de prueba y producción. También conviene identificar las versiones del modelo, las instrucciones, los documentos y las herramientas utilizadas. Si el proveedor cambia un modelo o la empresa actualiza su base documental, las cifras pueden dejar de ser comparables. En sistemas con evaluadores automáticos, además, hay que comprobar que el evaluador no esté introduciendo sesgos o errores sistemáticos. Microsoft documenta en Foundry cómo revisar resultados de evaluación, consumo de tokens y conjuntos de pruebas; es una referencia útil para entender la importancia de registrar esas evidencias, aunque la herramienta elegida sea otra.
El seguimiento financiero debe acompañar al seguimiento técnico. Un cambio de precio, una subida de tráfico o una nueva función que invoca servicios adicionales puede alterar el coste por tarea. No basta con calcular una vez y archivar la hoja de cálculo.
Tres errores que evitaría al presentar el retorno de inversión
El primero es equiparar ahorro potencial de tiempo con dinero ahorrado. Reducir quince minutos de una tarea no implica automáticamente que se reduzca una partida salarial. Puede liberar capacidad, mejorar el servicio o permitir absorber más demanda. Son beneficios posibles, pero conviene medirlos y describirlos correctamente.
El segundo es extrapolar el mejor resultado del laboratorio a todos los casos de producción. Las excepciones, los cambios de datos y la intervención humana suelen ser precisamente lo que diferencia una demostración de un sistema sostenible.
El tercero es ocultar los costes de adopción: formación, integración, rediseño de procedimientos, documentación, seguridad y mantenimiento. Esas actividades no son un fracaso del proyecto; son parte del trabajo necesario para hacerlo funcionar.
Una decisión tecnológica empieza por una unidad de valor
La inteligencia artificial ofrece posibilidades reales para reducir tareas repetitivas, mejorar la búsqueda de información y apoyar decisiones. Pero no todos los casos de uso justifican el mismo modelo, la misma arquitectura ni el mismo grado de autonomía. Elegir una solución solo por su precio por token puede conducir a conclusiones equivocadas.
Mi propuesta es sencilla: definir primero qué resultado merece la pena conseguir y medir después cuánto cuesta obtenerlo con calidad. Eso obliga a hablar de negocio, personas, datos y tecnología al mismo tiempo. Y permite distinguir una prueba prometedora de una inversión que realmente conviene sostener.
En BRR abordamos estas decisiones desde el Método BRR: entender el problema, revisar riesgos, priorizar, diseñar, formar, implementar y medir. La herramienta puede cambiar. La necesidad de justificar el resultado permanece.
Bárbara Regina Ribeiro · Fundadora de BRR. Tecnología aplicada con criterio.